Tú diriges la toma.
Nosotros escribimos el prompt.
Elige encuadre, escena, luz y lente como lo haría un fotógrafo. VisualPrompts convierte esas decisiones en un prompt detallado, con el formato que mejor leen Midjourney, ChatGPT, Nano Banana, Flux, Veo, Sora, Kling o Runway.
Dos formas de empezar.
Elige opciones o simplemente describe la toma en una frase.
Unas mismas decisiones.
Trece dialectos.
Cada modelo lee los prompts a su manera. Las mismas opciones, reformateadas para cada uno con un clic.
Tres tomas. Y listo.
Empieza por donde quieras
Carga una plantilla, describe la toma en una frase o pega un prompt que encontraste en internet.
Ajusta por secciones
Encuadre, escena, sujeto, vestuario, luz, cámara, color y estilo: unas 90 opciones sencillas en 15 secciones.
Copia para tu modelo
Elige el destino y copia. JSON o texto, negativos y parámetros con el formato correcto.
Para quien prefiere no escribir prompts.
Video centrado en el movimiento
En los modelos de video manda la acción: momentos en orden, movimiento secundario natural y movimiento de cámara, no la descripción de una foto congelada.
Vocabulario de fotógrafo
Lente, ángulo, profundidad de campo, dirección de la luz principal y temperatura de color, sin necesidad de saber los términos.
JSON o texto
JSON estructurado para ChatGPT y Gemini, frases separadas por comas para Midjourney, líneas etiquetadas para Veo.
Pulido con IA
Si quieres, deja que Claude reescriba el borrador para tu modelo, con tu propio plan de Claude.ai.
Coherente por diseño
Las opciones contradictorias se resuelven mientras eliges, así que un prompt nunca pide dos cosas a la vez.
Privado
Sin cuenta. Tus opciones y tu historial se quedan en tu navegador.
Parte de una toma.
Todos los ejemplos →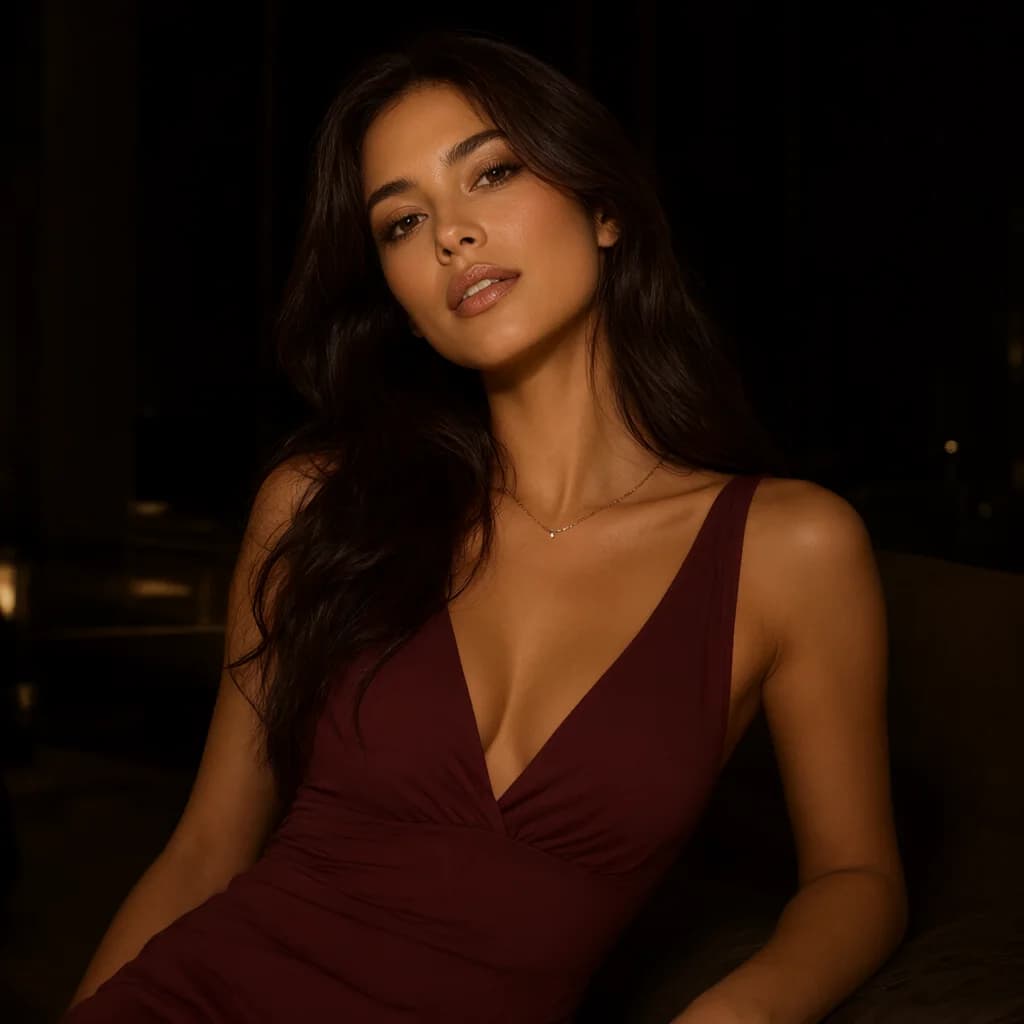 ImagenQwen-Image
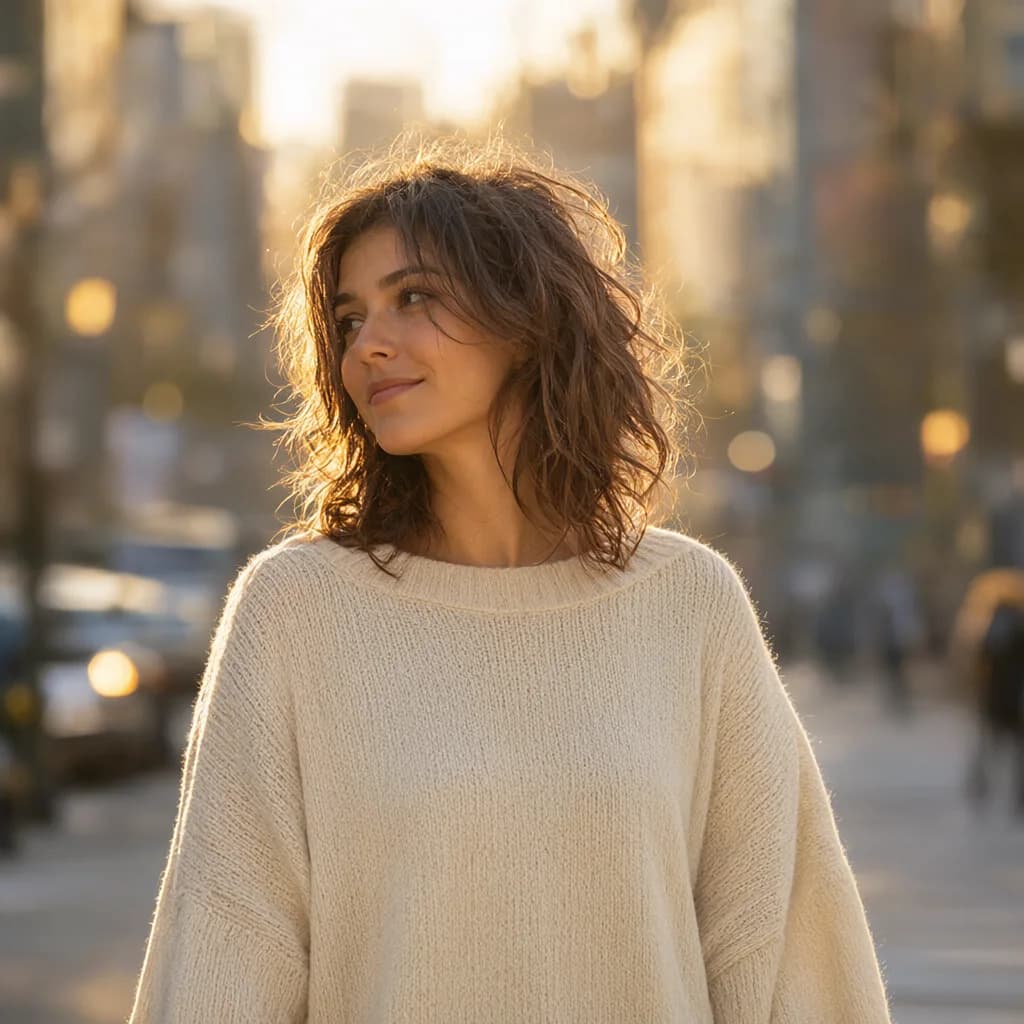 ImagenQwen-Image
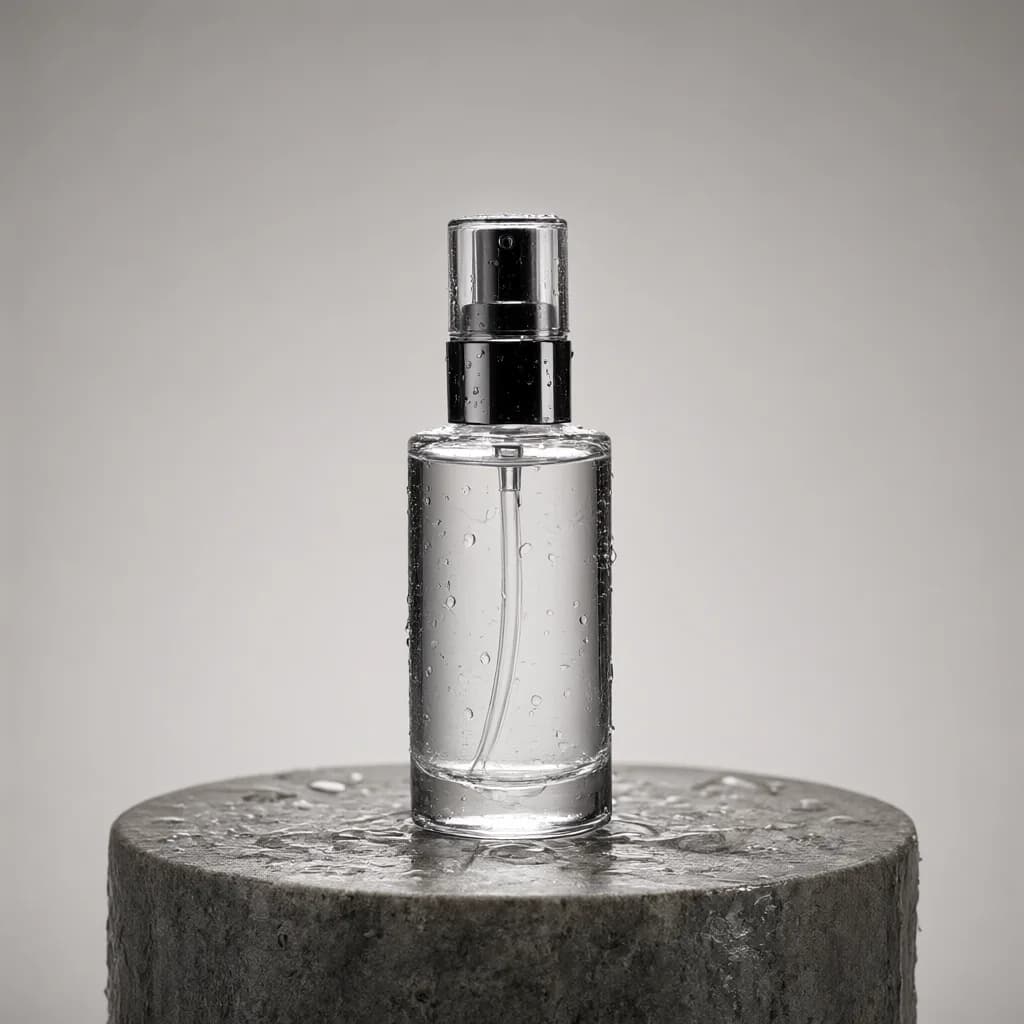 ImagenQwen-Image
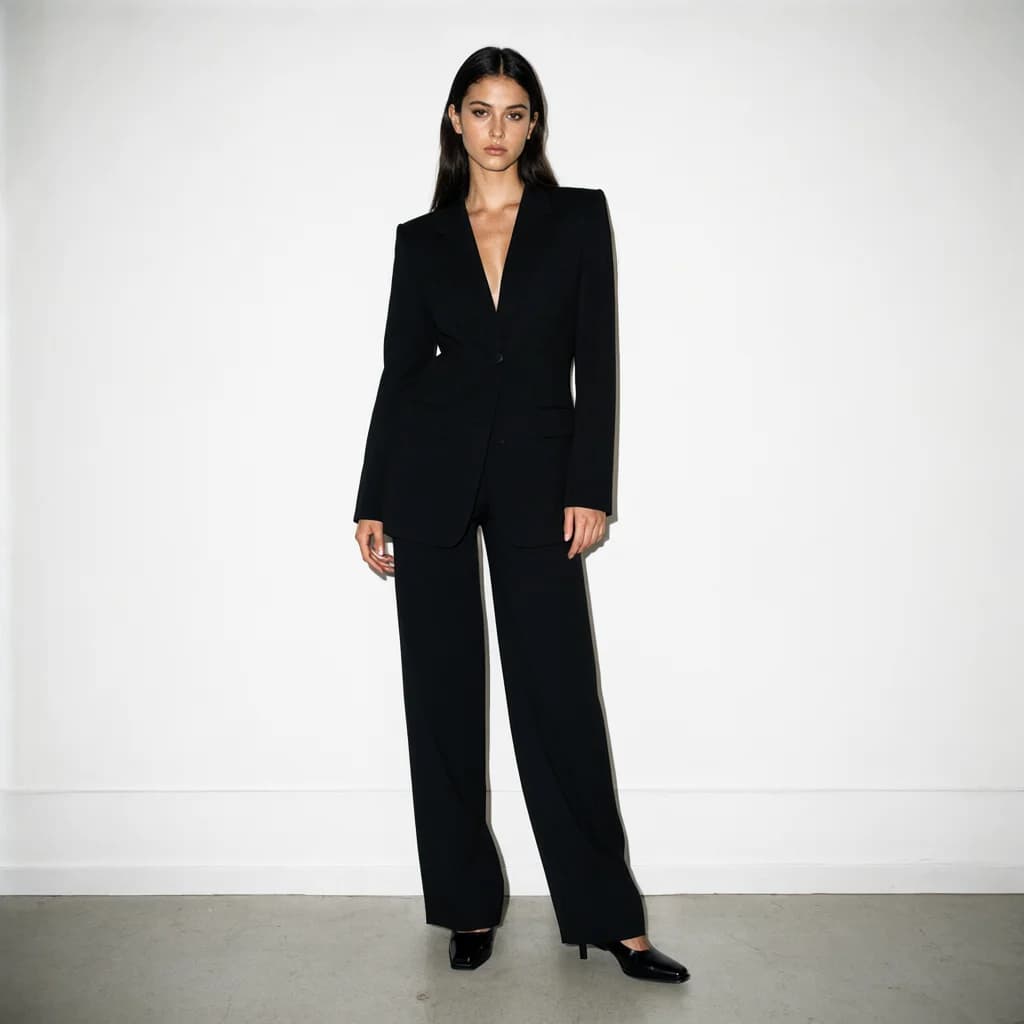 ImagenQwen-Image
 ImagenQwen-Image
 VideoWan 2.2
 VideoWan 2.2
 VideoWan 2.2
Preguntas.
¿Qué es VisualPrompts?+–
Un generador de prompts gratis para modelos de imagen y video con IA. Eliges opciones —plano, lugar, sujeto, vestuario, luz, cámara, composición, color y estilo— y escribe el prompt en el formato que espera tu modelo.
¿Qué modelos son compatibles?+–
Imagen: ChatGPT (GPT Image), Nano Banana (Gemini), Qwen-Image, Midjourney y Flux. Video: Veo, Sora, Kling, Runway, Luma, Seedance, Hailuo y Wan. Las mismas opciones se reformatean para cualquiera de ellos con un clic.
¿Es gratis? ¿Necesito una cuenta?+–
Es gratis y no hace falta registrarse. Tus opciones y tu historial se guardan solo en tu navegador.
¿Funciona para video?+–
Sí. Elige Veo, Sora, Kling, Runway, Luma, Seedance, Hailuo o Wan y el prompt se escribe como lo leen los modelos de video: primero la acción, luego la cámara, la luz y el sonido.
¿Puedo simplemente describir lo que quiero?+–
Sí. Escribe una frase en cualquier idioma y se convierte en una especificación completa y detallada que puedes ajustar y copiar para cualquier modelo.
¿Por qué los prompts cambian según el modelo?+–
Midjourney prefiere frases cortas y parámetros, Flux y Runway no tienen prompt negativo, ChatGPT maneja JSON largo y estructurado, y los modelos de video necesitan líneas separadas para la acción, el movimiento de cámara y el audio.